移动语义和右值引用
观前提醒:阅读本文只需要掌握最基础的指针、引用以及类的拷贝构造函数即可。文中会带你看一眼简单的汇编指令和标准库源码,即使完全没有学过汇编也不影响阅读
如果说
C++11只能保留一个新特性,无数人会把票投给移动语义,但这也是 C++ 新手村最大的重灾区,诸如左值、右值、纯右值、将亡值、右值引用……光看名字就让人头皮发麻。更离谱的是,很多人用了好几年std::move,却不知道它实际上根本没有移动任何数据
为什么我们已经有了 RAII,还不够?
在上一篇RAII详解(长篇)我们聊过 C++ 的资源管理机制
C++ 中很多复杂的类,比如 std::vector、std::string,对象本身通常只需要保存一些管理信息,例如指向堆内存的指针、当前大小和容量,而真正的数据可能存放在堆空间中
换句话说,对象本身只是资源的持有者
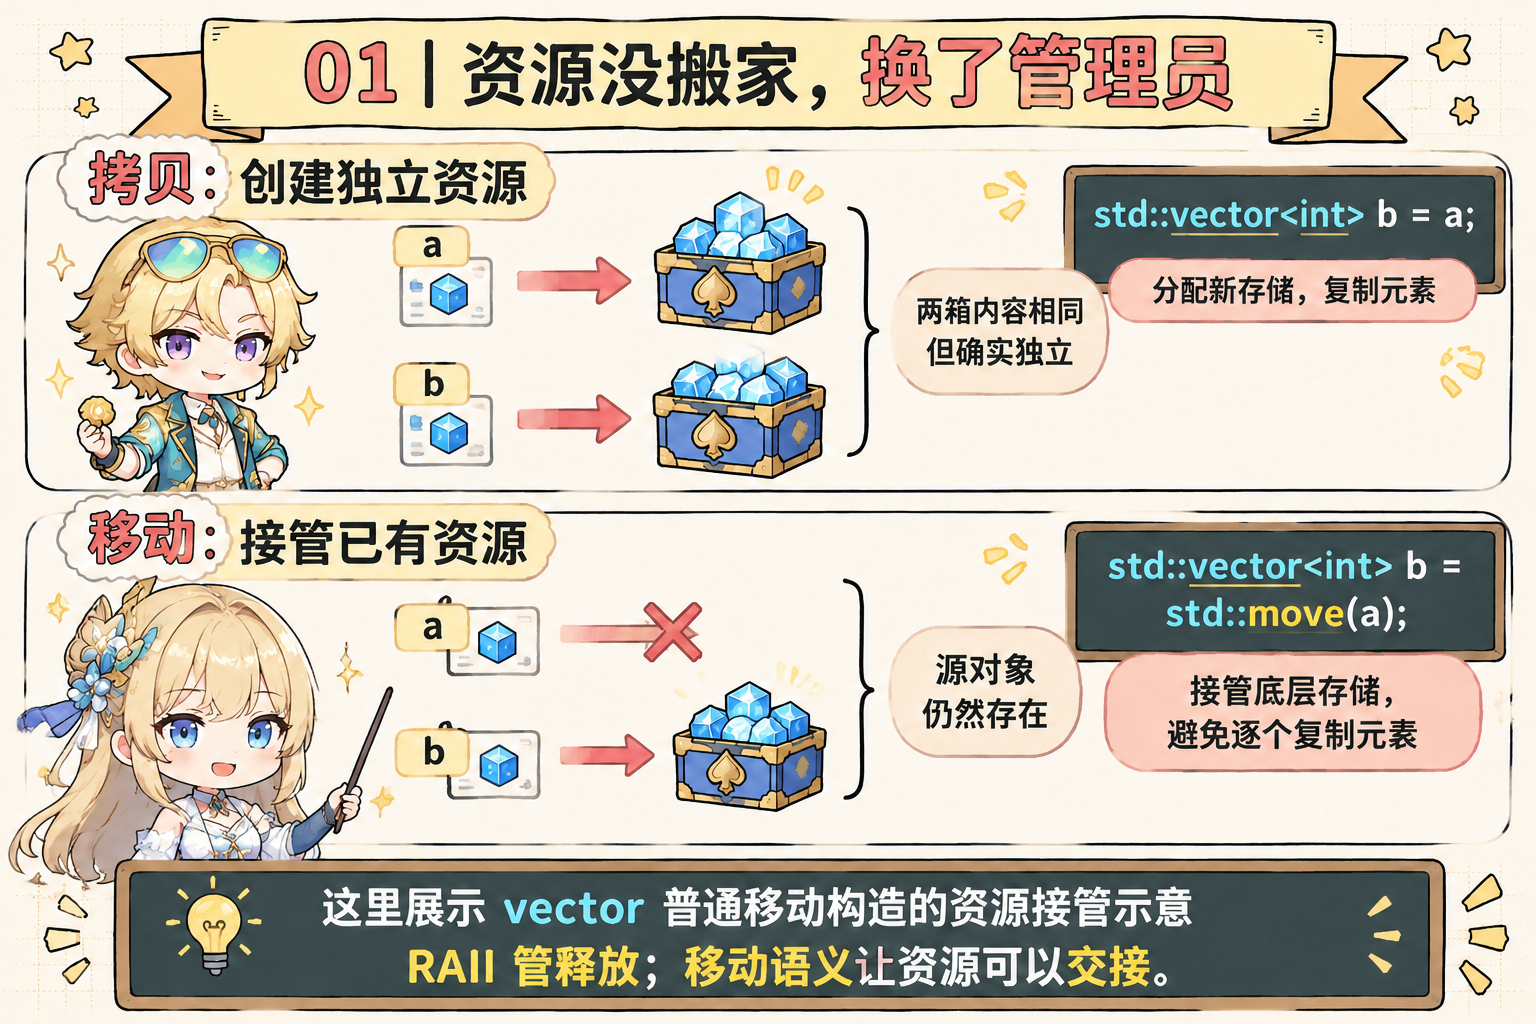
在 C++11 之前,如果你想把一个对象的数据交给另一个对象,通常需要通过拷贝构造函数完成
1 | vector<int> v1(1000000,1); |
这意味着什么?
v2 需要重新申请一块内存,然后把 v1 中的一百万个整数复制过去
即使 v1 马上就要离开作用域、即将销毁,也无法直接把它的资源交给 v2
当然,这里有一个容易忽略的细节,C++11 之前也存在编译器优化,例如返回值优化(RVO),并不是所有临时对象都会产生实际的深拷贝
但对于已经存在的对象之间的资源转移,传统拷贝机制确实存在不必要的开销
能不能别这么傻?
既然旧对象马上就要销毁,我直接接管它指向堆内存的指针,再把它的指针置空,让它的析构函数安全处理不就完事了吗?
例如
1 | data = other.data; |
不需要重新申请内存,也不需要复制一百万个整数,直接转移资源的所有权即可
这就是移动语义(Move Semantics)想要解决的问题
移动的重点从来不是底层数据本身,而是资源所有权的转移
但问题来了:编译器如何判断什么时候必须进行深拷贝,什么时候可以安全地转移原对象的资源?
只有先立规矩才能不烧心,为了给编译器立下这套规矩,解决这个问题,C++11 引入了右值引用,并进一步完善了表达式的值类别体系
到底什么是左值和右值?
在《C++ Primer》中有一句非常经典的总结:
当一个对象被用作右值的时候,用的是对象的值(内容);当对象被用作左值的时候,用的是对象的身份(在内存中的位置)
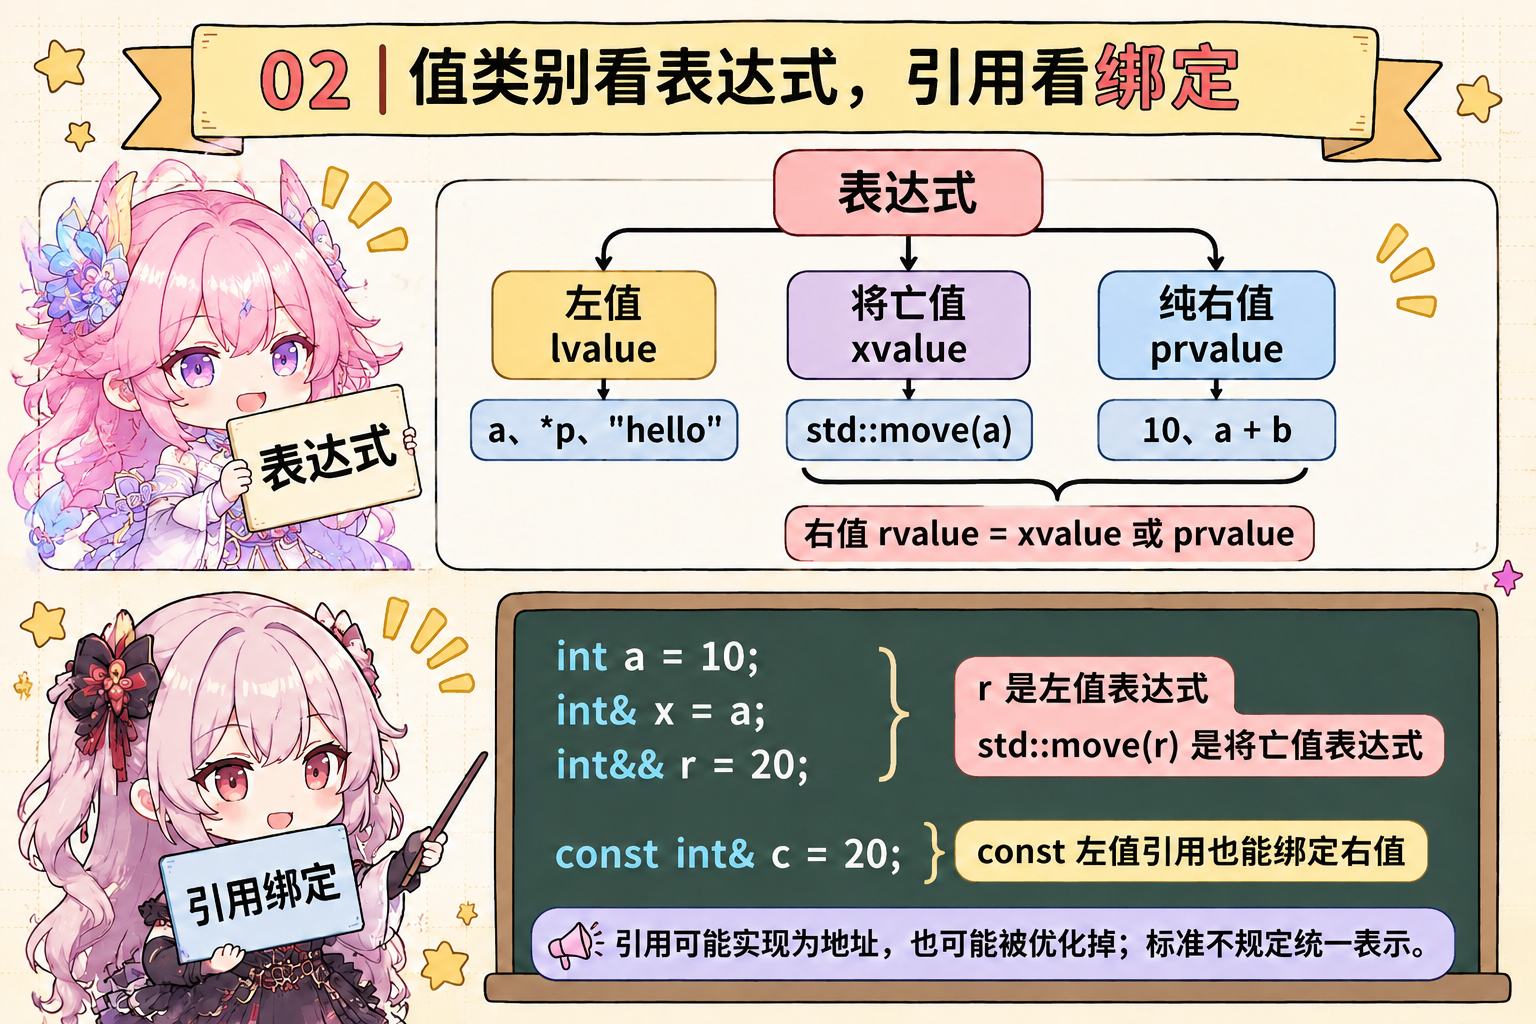
如果要理解这个概念,首先需要明确:左值和右值描述的是表达式的值类别,而不是变量本身的属性
区分左值和右值只需要问一个问题:能不能用 & 符号对它取地址?
左值(lvalue)左值表达式表示一个具有身份的对象或函数
最常见的例子就是普通变量:
1 | int a = 10; |
这里的 a 就是左值,因为它表示一个具有身份的对象,可以通过它访问和修改对应的变量
其他常见例子还有:
1 | int a = 10; |
其中,字符串字面量 “hello” 的类型是 const char[6],它也是左值
从汇编角度看:
1 | int a=10; |
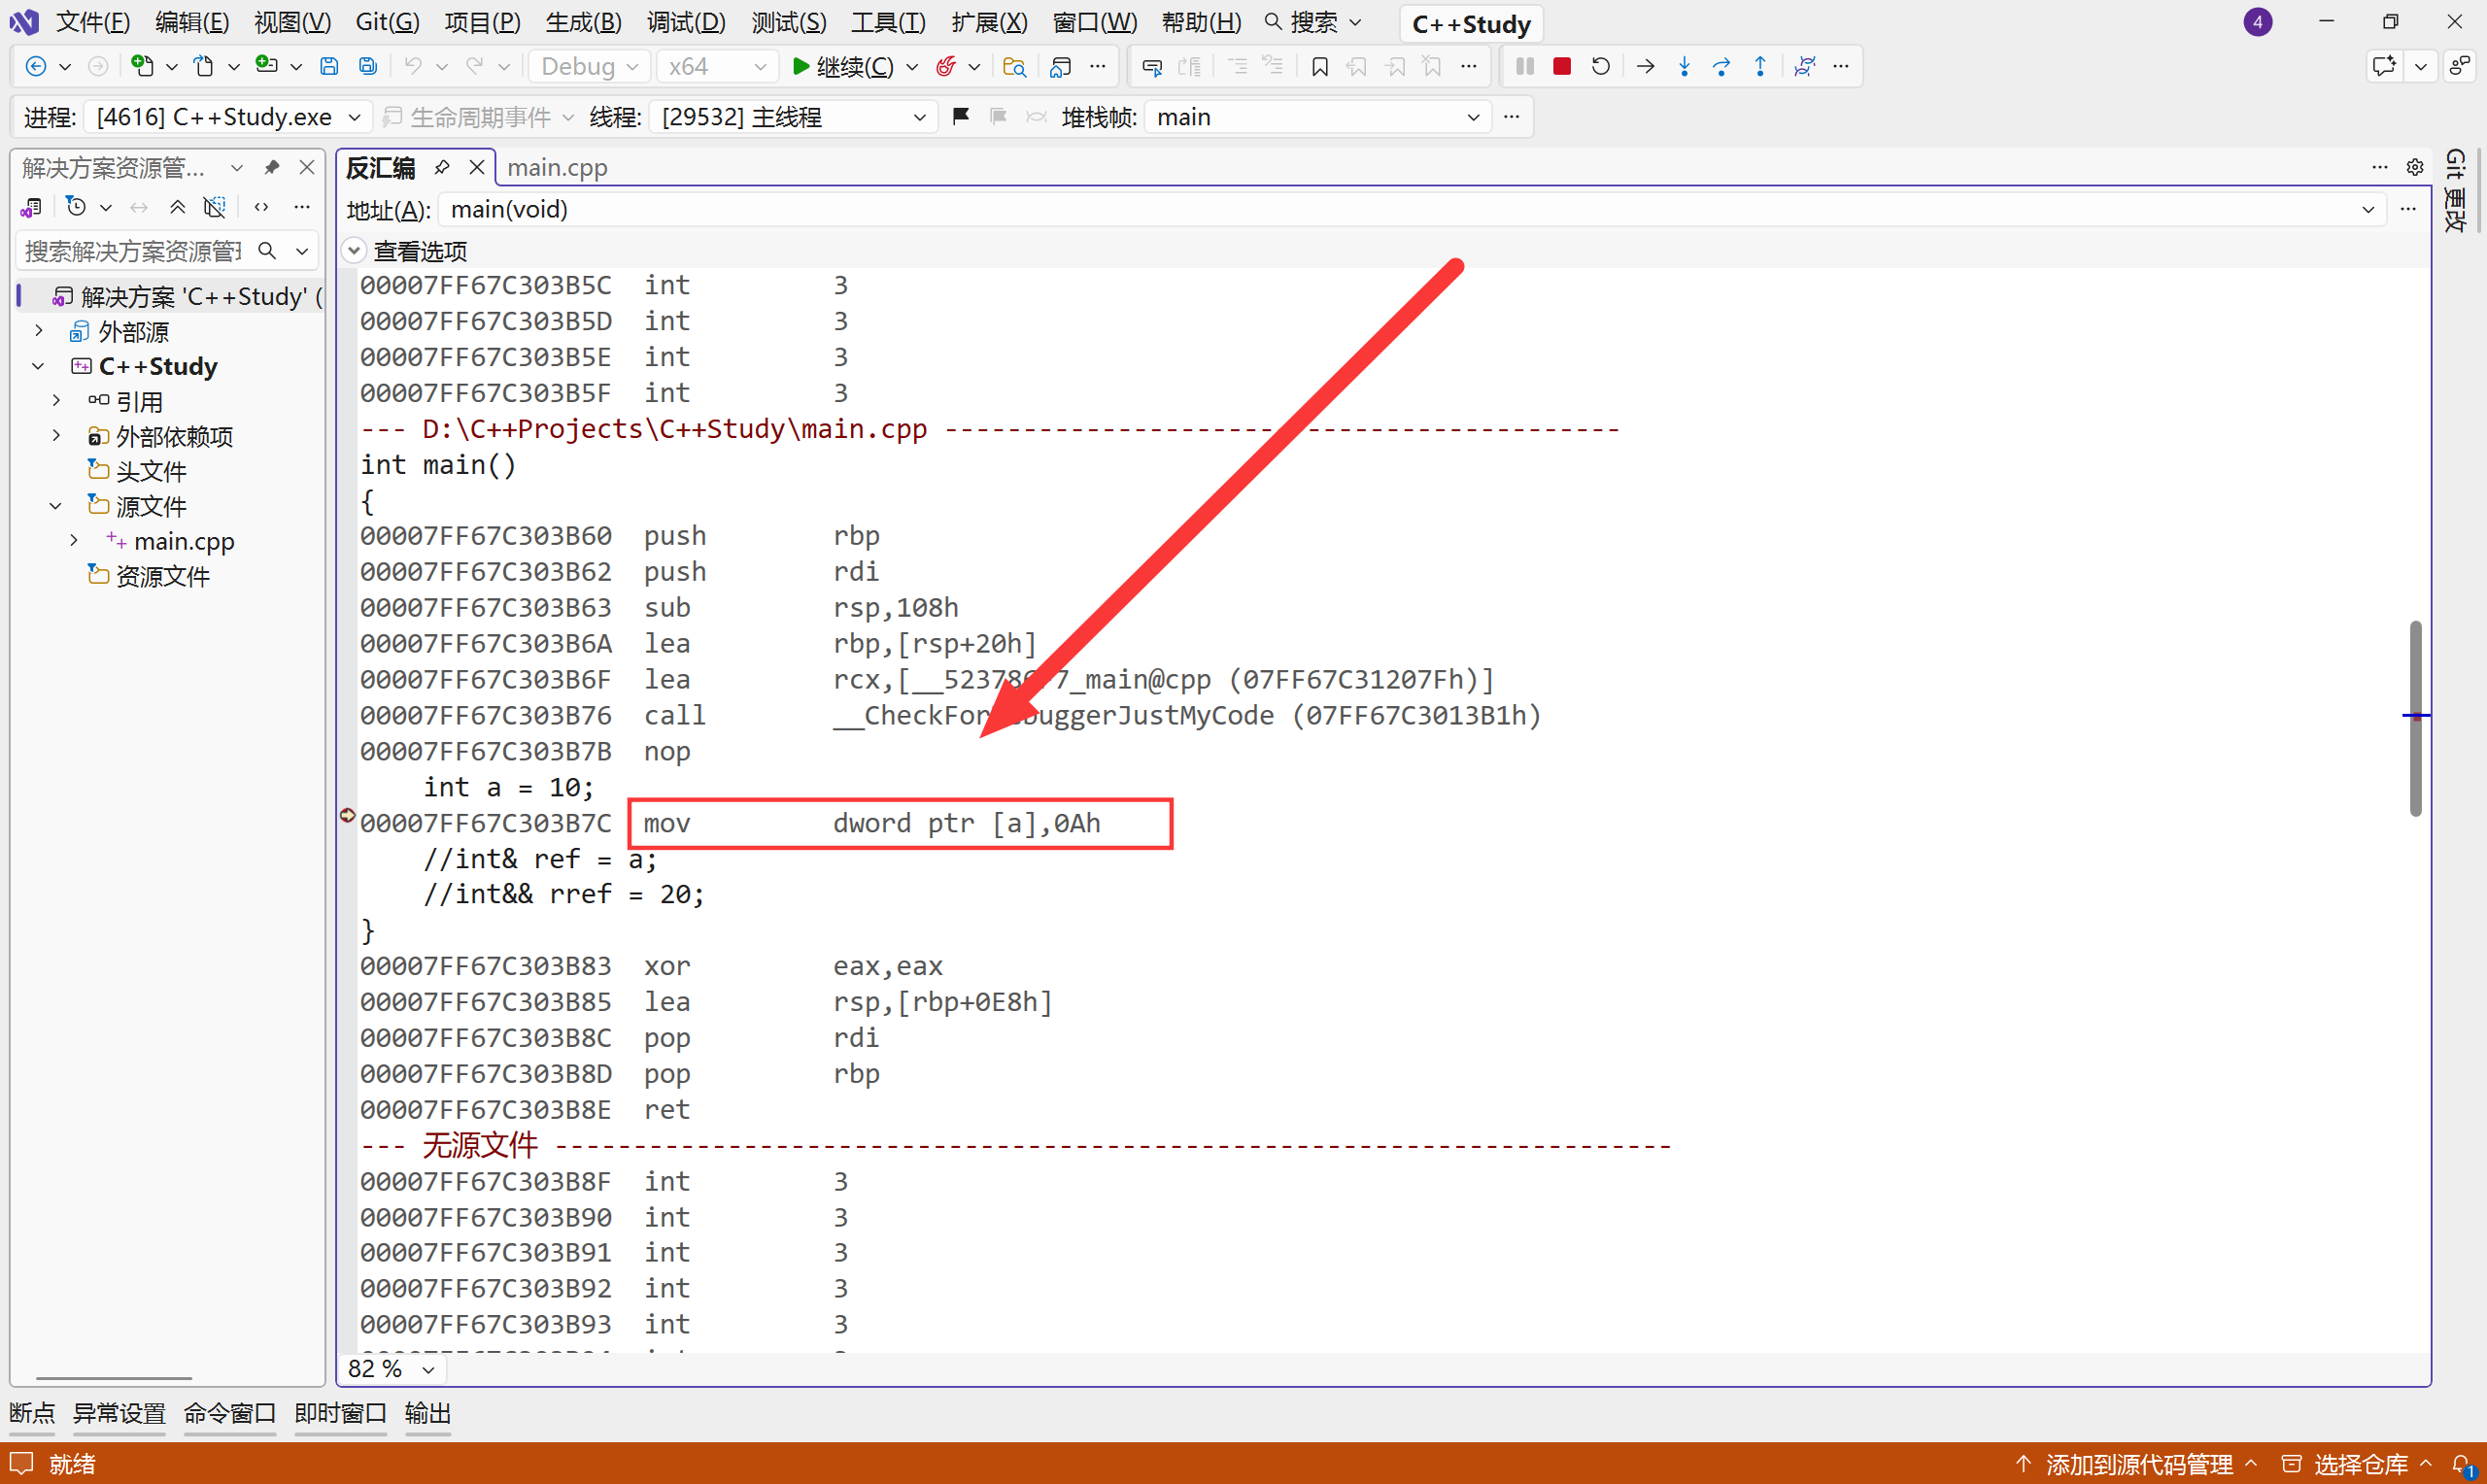
在一种常见的 x86 汇编表示中,可能对应:mov DWORD PTR [a], 10
这里的 [a] 就是实际的内存地址,该语句执行完之后,a 仍然存在于栈上
由于左值在当前语句结束后仍然存在,后续代码随时可能读取它,因此编译器不能随意转移左值的资源
右值(rvalue)则是一个更大的概念,它包含两种值类别:纯右值(prvalue)和将亡值(xvalue)
先看最常见的纯右值:
1 | 10; |
这些表达式都属于纯右值,它们通常用于产生一个值,或者初始化某个对象
再看将亡值:
1 | int a = 10; |
这里的 std::move(a) 就是一个将亡值,它与纯右值最大的区别在于将亡值仍然具有对象身份,只是表达式表明这个对象的资源可以被复用
因此,不能简单地认为右值就是没有地址的临时对象,也不能认为右值表达式结束后对象一定立即销毁
汇编之下,众生平等
搞懂了左值和右值,我们再来看 C++ 里的两种引用:左值引用(T&)和 C++11 新增的右值引用(T&&)
很多初学者一看到两个 && 就开始犯怵,这到底是什么高深莫测的语法,其实不管是左值引用还是右值引用,在语言层面它们都只是对象的“别名”,在底层汇编层面它们全都是指针
1 | int a=10; |
在底层汇编里,编译器是怎么处理这两行代码的?
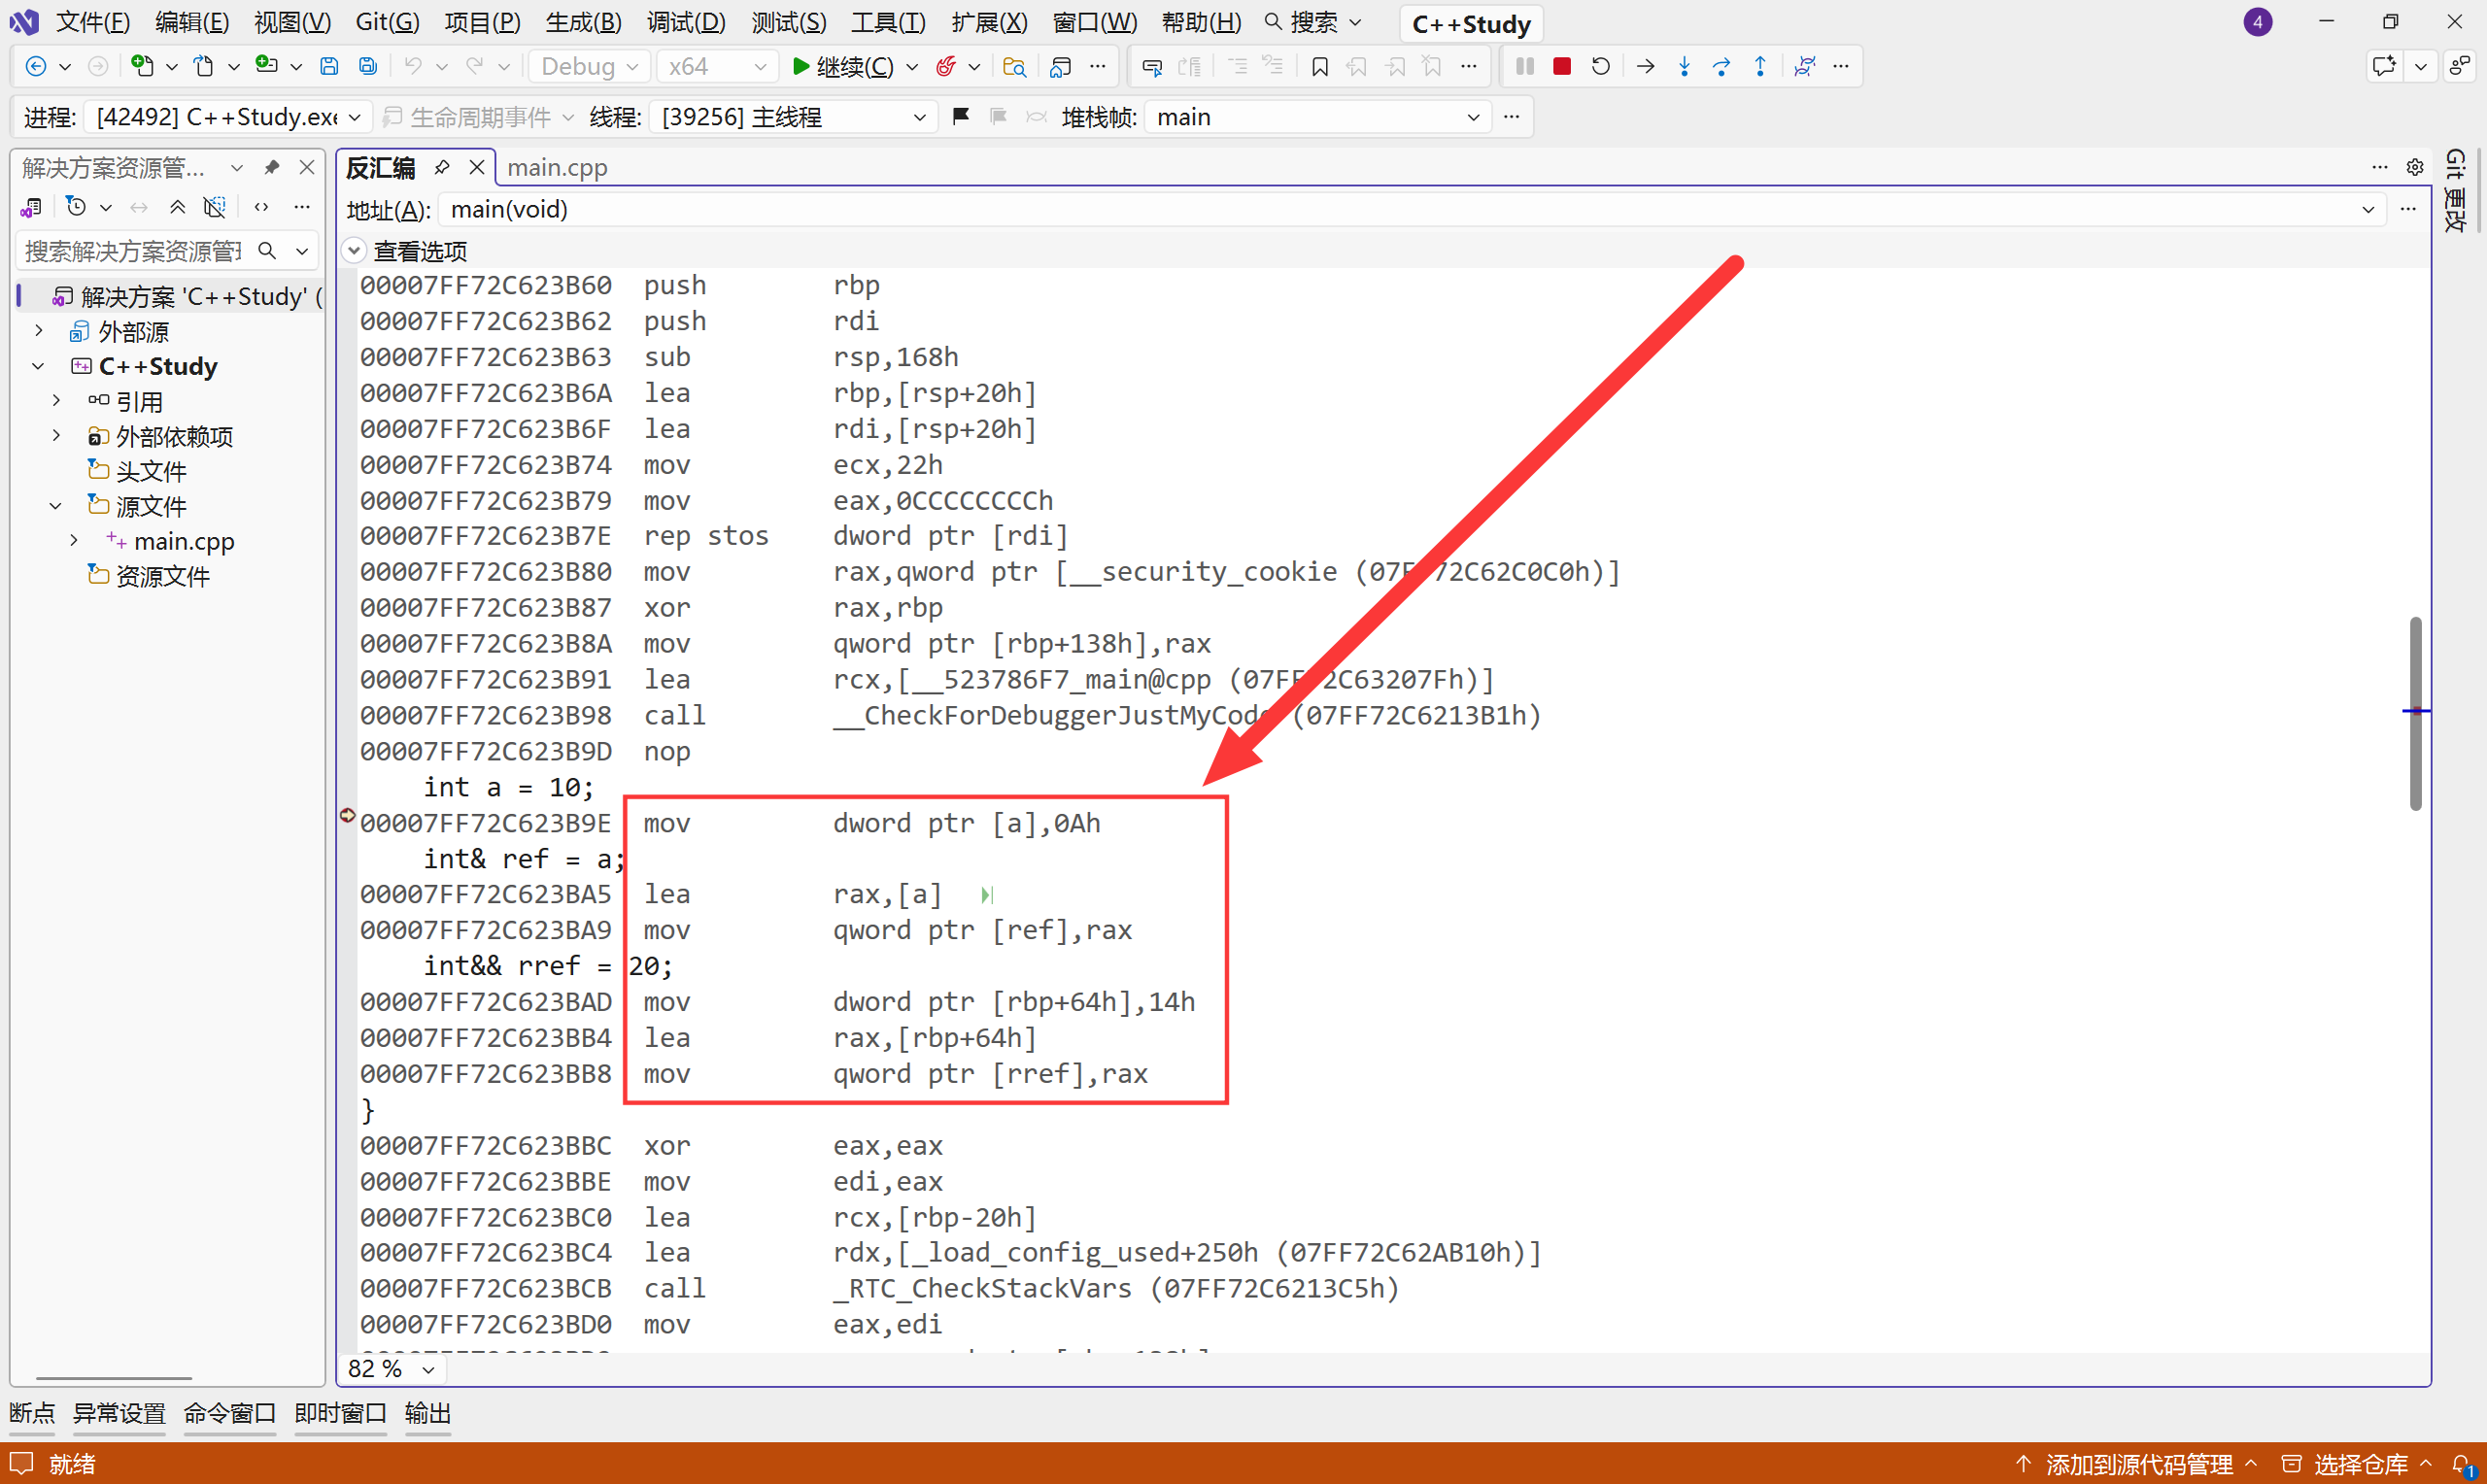
对于 int& ref = a;,编译器先取变量 a 的地址(lea rax, [a]),再将该地址存入 ref 对应的栈空间(mov [ref], rax)。
此后对 ref 的读写,均通过一个本身不可变的指针(int* const)间接访问 a
对于 int&& rref = 20;,字面量 20 本身没有地址,编译器会在栈上创建一个匿名临时变量,先将 20 写入其中(mov DWORD PTR [tmp], 20),再取出该临时变量的地址存入 rref(lea rax, [tmp] → mov [rref], rax)
看到了吗?在机器码层面,左值引用和右值引用并没有什么区别,全都是存了一个内存地址而已
那 C++11 费尽心机发明 T&& 到底图啥?其实是为编译期的类型检查和函数重载提供一种可区分的类型标识
非 const 的左值引用 T& 只能绑定左值
补充一点:C++98 允许常量左值引用 const T& 绑定右值,如 const int& r = 10;,但因带有 const,无法通过它修改并转移该对象
右值引用 T&& 只能绑定右值。只要函数参数声明为 T&&,编译器在编译阶段就能确定传入的实参是临时对象(或调用方主动放弃的资源),因此函数内部可以安全地转移其底层指针
注意右值引用绑定的是右值,但右值引用变量本身是左值,例如 int&& rref = 20; 声明后,rref 有名字,可以写 &rref 取地址。
因为有名字、能取地址,所以 rref 本身是左值
移动构造函数
铺垫了半天左值、右值和 T&&,现在终于可以干正事了,如何让自己的类真正支持不深拷贝数据、直接转移指针?
答案是利用函数重载(Function Overloading),在类里同时提供两个版本的构造函数:
如前所述的拷贝构造函数 T(const T& other):参数为常量左值引用,传入普通左值时,编译器匹配该构造函数,分配新内存并复制数据,相关内容参考拷贝构造函数
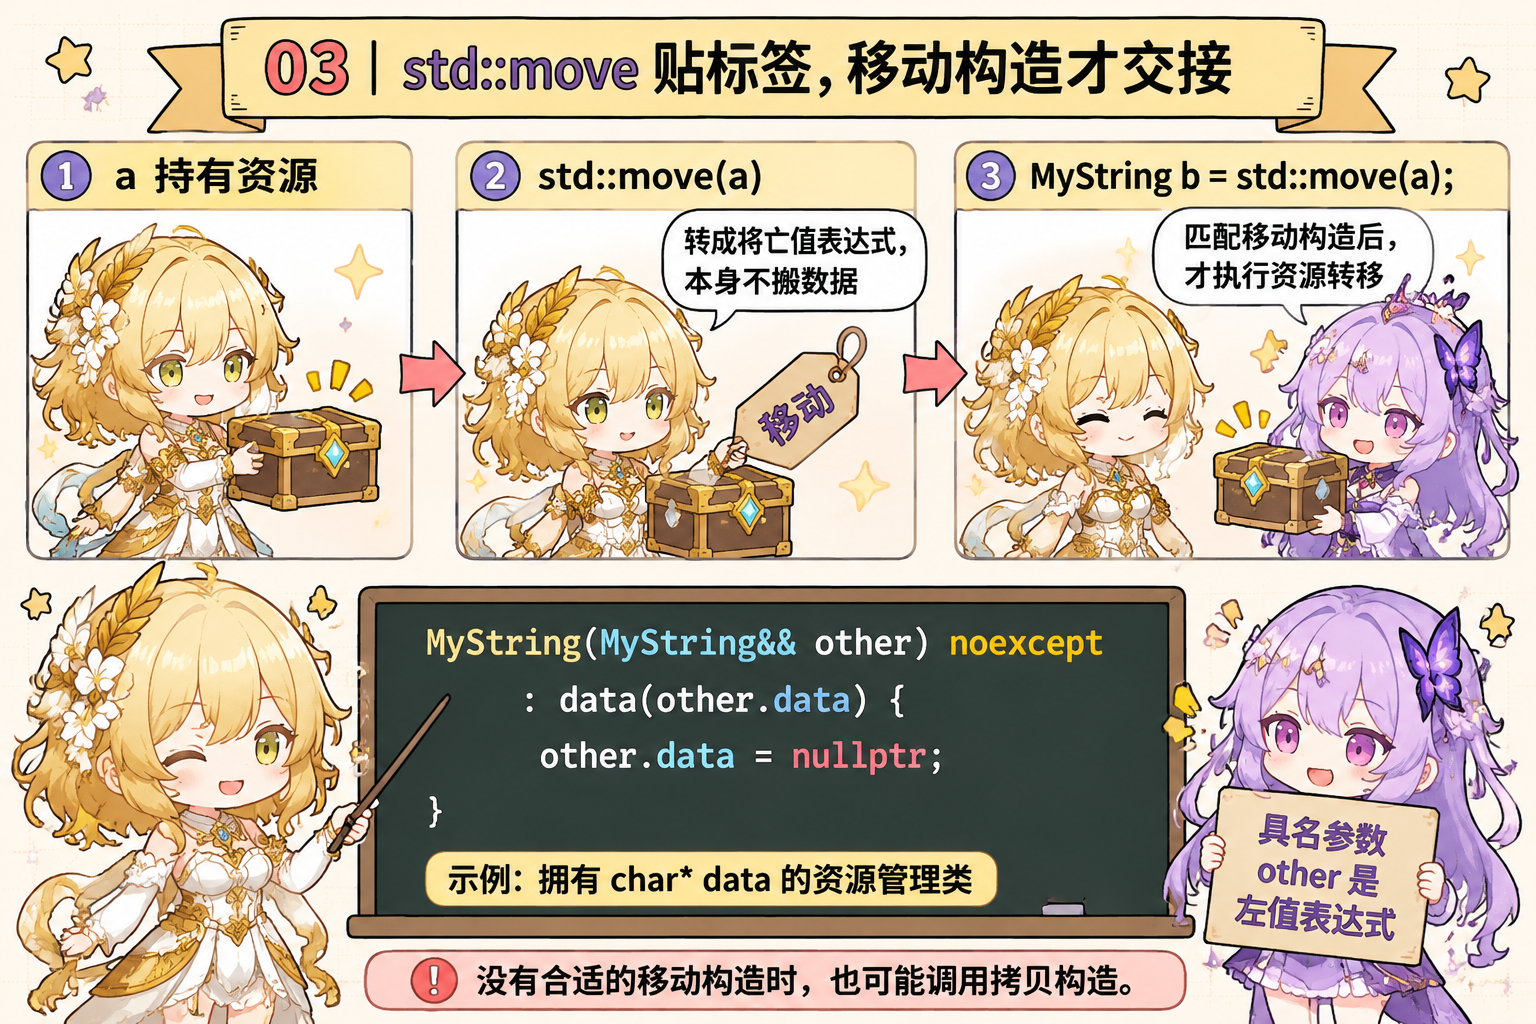
移动构造函数 T(T&& other):参数为 C++11 新增的右值引用,若传入的是即将销毁的右值(如临时对象),重载决议会优先选择该构造函数
用一个管理堆内存的 MyString 对比拷贝构造和移动构造:
1 | class Mystring |
移动构造只有两步:
- 取得指针:
data(other.data),不分配新内存,也不复制数据,直接取得源对象的指针 - 置空源指针:
other.data = nullptr
若不置空,源对象析构时会 delete[] 刚被取得的堆内存;置空后 delete[] nullptr 为空操作,内存可安全转移
移动赋值 operator=(T&&) 同理,只是在取得对方指针前,要先释放自身原有资源
那么左值怎么办?MyString str2 = str1; 中 str1 是具名左值,MyString&& 不能绑定左值,只会匹配拷贝构造
若确定 str1 后续不再使用,用 std::move(str1) 将其转换为右值,即可匹配移动构造
史上最大的标题党函数
前面我们提到,右值引用变量本身是左值
那么,如何让一个已经存在的左值参与移动操作?
答案就是 std::move
但这里有一个非常容易产生误解的地方:std::move 这个函数本身并不会移动任何数据,它只是一个类型转换工具
很多人第一次看 <utility> 头文件里 std::move 的源码时都会感到意外
我们先看一个简化后的标准库实现
1 | template<class T> |
为了方便理解,先把模板、类型萃取等细节放到一边,它的核心本质就是:
1 | return static_cast<T&&>(t); |
通过 static_cast 将对象转换为右值引用对应的表达式类别
为什么需要 remove_reference?
因为模板推导会根据传入参数的类型决定 T
例如:
1 | int a = 10; |
这里 a 是左值,模板推导得到:T = int&
如果不去除引用,直接处理 T&&,就会遇到引用折叠规则
因此,标准库需要先去除引用,再添加右值引用
最终:remove_reference_t<int&>&& 就变成了 int&&
前面我们实现了移动构造函数,但移动语义还有另一个重要成员:移动赋值运算符
它们的区别其实很简单:
1 | MyString a("Hello"); |
移动构造是创建一个新对象,而移动赋值是将资源转移给一个已经存在的对象
因此,移动赋值需要先处理目标对象原本持有的资源
1 | MyString& operator=(MyString&& other) noexcept |
至此,一个简单的类就同时具备了拷贝构造、移动构造、拷贝赋值和移动赋值能力
不知道你有没有注意到,前面的移动构造函数都加了一个关键字:
1 | MyString(MyString&& other) noexcept |
这个 noexcept 是 C++11 引入的异常说明,表示该函数承诺不抛出异常
为什么移动构造函数经常需要加它?
因为标准库容器在进行扩容等操作时,需要考虑异常安全保证
1 | std::vector<MyString> vec; |
当 vector 的容量不足,需要重新分配内存时,就可能需要将旧存储区中的元素转移到新的存储区
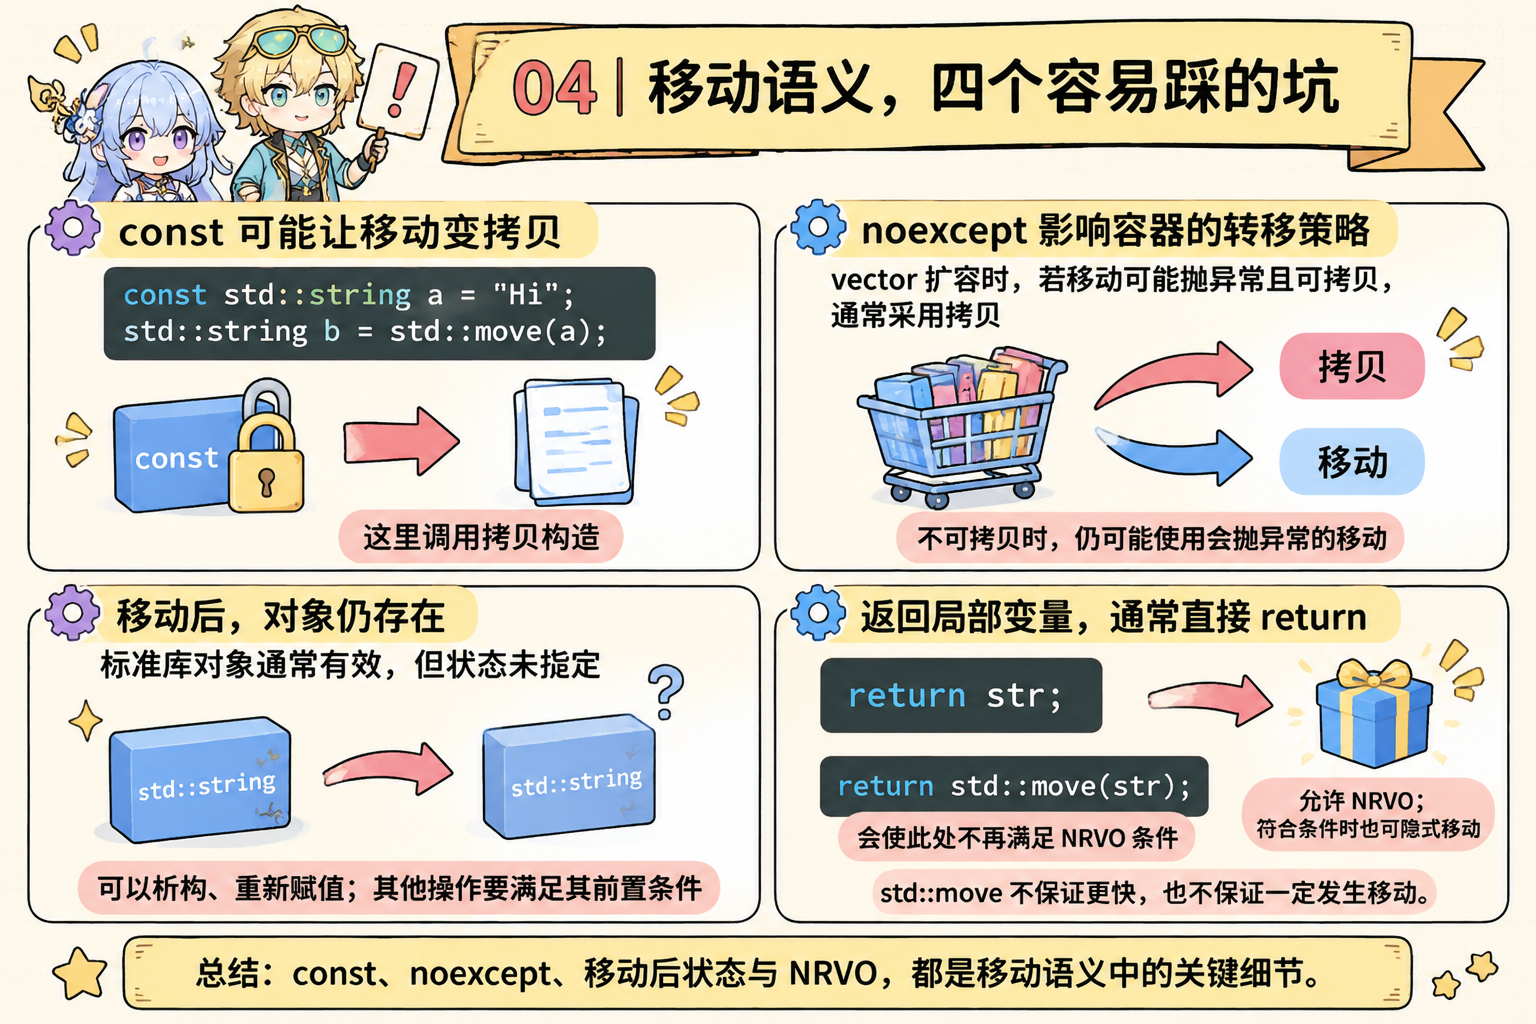
如果移动构造函数没有 noexcept 标记:std::vector 为了保证强异常安全性(即如果扩容过程中发生异常,要能回滚,保证原 vector 数据不被破坏),它不敢使用移动构造函数,而是会退而求其次,使用拷贝构造函数(Copy Constructor)。
拷贝的开销通常比移动大得多(需要重新分配内存并复制所有数据)
考虑性能,这是加上 noexcept 最重要的原因
正因如此,标准库甚至专门提供了一个 std::move_if_noexcept 工具
1 | std::move_if_noexcept |
在对象没有 noexcept 移动构造时自动回退到拷贝,这里就不详细展开了,讲了这么多理论,最后回到最开始的例子
1 | std::vector<int> a(1000000, 1); |
这里执行的是拷贝构造,b 需要拥有自己独立的元素存储空间,因此通常需要分配新内存并复制一百万个整数
1 | std::vector<int> a(1000000, 1); |
这次则可以调用 vector 的移动构造函数,对于常见的标准库实现,vector 可以直接接管原来的底层存储资源,而不需要逐个复制一百万个整数,这就是移动语义带来的价值,不过,这里还有几个必须知道的细节
移动后的对象还能使用吗?
当然可以,移动操作并不意味着源对象被销毁,对于标准库类型,移动后的对象通常处于有效但未指定的状态(valid but unspecified state)
std::move 一定比拷贝快吗?
不一定,学会了移动语义之后,很多新手会患上一种 move 强迫症
觉得只要加上 std::move 性能就能起飞,甚至连 int、double 都想要 std::move 一把
实际上,对平凡类型与标量类型(Trivial / Scalar Types)来说,std::move 是毫无收益的
移动之所以快,唯一的原因是它通过转移指针避开了堆内存等外部资源的深拷贝
但对于 int、double、裸指针,或者内部全是定长栈数组的 std::array<int, 100>,它们所有的数据都直接嵌在栈对象内部
同时如果编译器在 Debug 模式或复杂调用链下没有将 std::move 及移动构造函数内联(Inline),多出来的函数跳转(call 指令)开销,对于小对象来说反而比直接按位复制还要慢
如果你自己写的类没有定义移动构造函数(或者因为手写了析构函数导致编译器不再自动生成移动构造)
编译器在重载匹配找不到 T(T&&) 时,也会默默退化去调用 T(const T&) 拷贝构造函数
所以 std::move 只负责类型转换,并不保证后续操作一定执行移动构造
1 | const std::string a = "Hello"; |
因为 a 是 const 对象,所以这里可能发生拷贝
std::move(a) 转换后得到的是 const std::string&&
而普通移动构造函数的参数是
1 | std::string(std::string&& other); |
它无法绑定到 const std::string&&。
因此,通常会匹配接受 const std::string& 的拷贝构造函数。
这也是为什么不要随意给所有对象加上 std::move
返回局部变量时,需要手动 std::move 吗?
通常不需要
1 | std::string createString() |
这里编译器可能直接进行返回值优化(NRVO),让对象在最终返回位置直接构造
如果无法进行复制消除,符合条件的局部变量在返回时也可能触发隐式移动
反而写成:
1 | return std::move(str); |
可能阻碍 NRVO,因为返回表达式已经不再是直接返回具名局部变量,请注意!
参考资料
- LummiGhost鬼明.
【短的C++】移动语义[EB/OL].
Bilibili, 2025-11-28
[2026-11-13]. https://www.bilibili.com/video/BV1zzSEBGE7t. - 夏曹俊.
c++新特性,如果只保留一个就是move移动语义,详细分析一下move语义,并作代码演示 #C++ #move #cpp #RAII[EB/OL].
Bilibili, 2025-01-13
[2026-11-13]. https://www.bilibili.com/video/BV1zBc2e4E4g. - 程序员陈子青.
深入浅出C++左值与右值 —— 一个视频彻底搞懂左值与右值![EB/OL].
Bilibili, 2025-03-19
[2026-11-13]. https://www.bilibili.com/video/BV1wvX7YtEk3. - mq白cpp.
全网第一C++移动语义讲解![EB/OL].
Bilibili, 2024-01-13
[2026-11-13]. https://www.bilibili.com/video/BV1FN4y1p729.